AMD 推出的 Lemonade:使用 GPU 的快速开源本地 LLM 服务器……
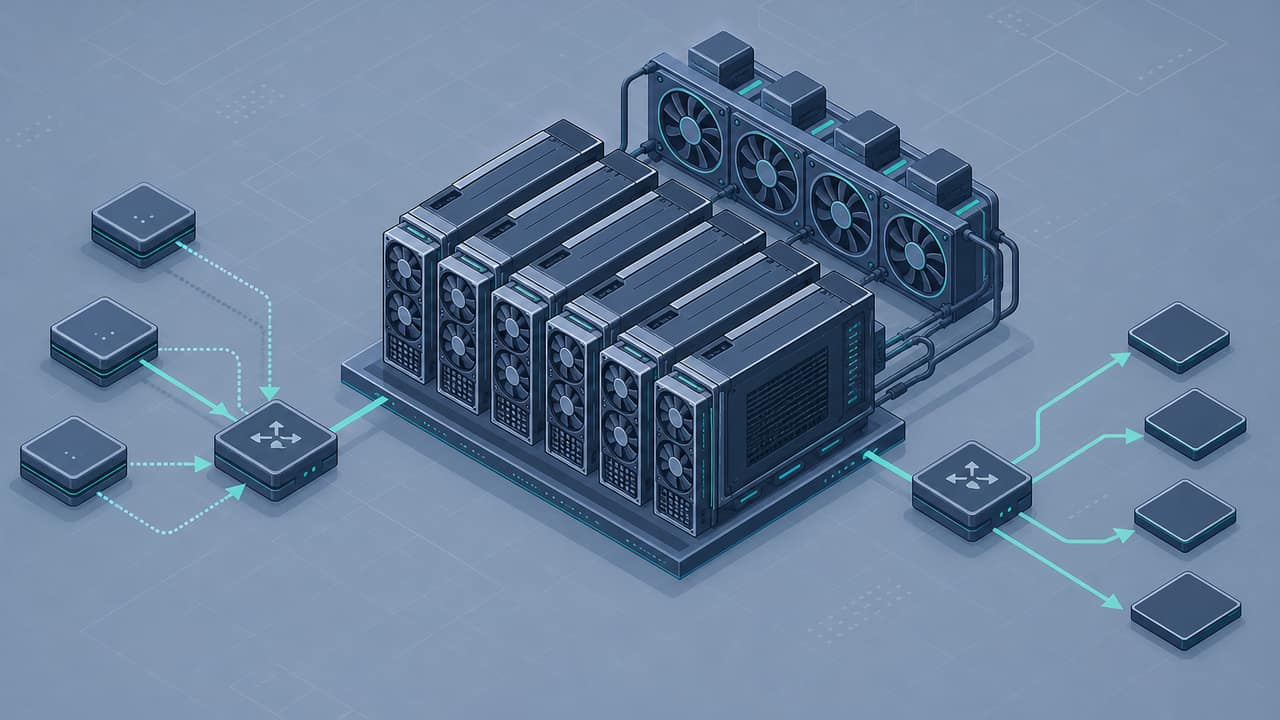
AMD 的 Lemonade:利用 GPU 和 NPU 的快速开源本地 LLM 服务器
一个实用的本地 LLM 服务器,如果回答一个 20 token 的提示词需要 18 秒,那么它的“本地”意义就不复存在了。我在开发者笔记本电脑上反复见过这种情况:模型从技术上确实能运行,CPU 使用率一直维持在 700%,风扇高速运转,而第一个 token 到达时,用户早已忘了刚才的上下文。
这就是 Lemonade 试图解决的工程问题:让本地推理用起来像真正的服务,而不是演示脚本。
AMD 的 Lemonade 是一款开源本地 LLM 服务器,旨在客户端硬件上运行语言模型,尤其是支持 GPU 和 Ryzen AI NPU 加速的 AMD 系统。值得关注的不只是“在本地运行模型”。我们已经有多种方式可以做到这一点。真正值得关注的是它的服务器架构:通过 API 提供本地模型,将推理任务路由到可用的加速器,并让普通应用代码能够使用它。
对于构建本地辅助工具、私密文档助手、智能体沙箱或离线推理工作流的工程师来说,这正是合适的抽象方式。你不会希望每个应用都要了解如何加载模型、量化权重、选择执行提供程序、锁定内存、流式输出 token 和管理会话。你需要的是一个本地推理服务。
Lemonade 实际上用来做什么
从整体来看,Lemonade 是一个本地模型服务器,位于应用与硬件之间。
你无需将推理逻辑直接嵌入应用,而是运行一个本地守护进程:
lemonade-server serve然后,应用通过 HTTP 与它通信,通常使用 OpenAI 风格的聊天补全 API:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/api/v1",
    api_key="not-needed-for-local"
)

response = client.chat.completions.create(
    model="llama-3.1-8b-instruct",
    messages=[
        {"role": "system", "content": "You are a concise coding assistant."},
        {"role": "user", "content": "Write a Python function to chunk text by tokens."}
    ],
    temperature=0.2,
    stream=True,
)

for chunk in response:
    delta = chunk.choices[0].delta.content
    if delta:
        print(delta, end="", flush=True)
API 的形式很重要。如果你的后端已经支持 GPT-5.5、Claude Sonnet 4.6、Gemini 3 或某个开放模型端点,通常可以将同一个客户端抽象接入 Lemonade,在本地执行。这样,你就能测试模型路由、涉及隐私敏感信息的功能和离线工作流,而无需围绕新的 SDK 重写应用。
在实践中,我将本地 LLM 服务器视为一个基础设施组件:
App / IDE / Agent Runtime
        |
        | HTTP streaming chat API
        v
Lemonade local server
        |
        | model loader + scheduler
        v
Execution backend
        |
        | GPU / NPU / CPU fallback
        v
AMD client hardware
正是这种清晰的职责分离,让它能够用于实际系统。
为什么 GPU 和 NPU 都很重要
大多数工程师已经理解 GPU 加速为何对 LLM 推理很重要:矩阵乘法占据了大部分运行时间,而 GPU 专为并行运算而设计。NPU 则是较新的概念,也更容易被误解。
NPU 并不是“更小的 GPU”。它是一种专用加速器,针对严格功耗和散热限制下的神经网络运算进行了优化。这对笔记本电脑很重要。最佳的本地推理技术栈,并不总是在持续 30 秒的基准测试中获得最高每秒 token 峰值的那个。它往往是在用户同时运行 Slack、浏览器、VS Code 和 Docker 时,仍能保持响应流畅的那个。
一个有用的理解方式:
- GPU:更适合较大的模型、更高的吞吐量和繁重的并行计算。
- NPU:适合低功耗、始终运行,以及较小或经过优化的模型。
- CPU:可靠的后备方案,但用于交互式 LLM 时通常延迟较高。
- 混合系统:适合根据模型大小、量化方式和可用性来路由任务。
例如,本地助手可能会使用:
{
  "routes": {
    "autocomplete": {
      "model": "small-code-model",
      "device": "npu",
      "max_tokens": 64
    },
    "chat": {
      "model": "llama-3.1-8b-instruct-q4",
      "device": "gpu",
      "max_tokens": 1024
    },
    "summarization": {
      "model": "compact-instruct",
      "device": "auto",
      "max_tokens": 512
    }
  }
}
这就是我喜欢的模式:不要执着于某一种加速器。为每种工作负载选择合适的执行目标。
Lemonade 在本地 LLM 服务器中的定位
如今已有多种成熟的本地推理方案。Lemonade 的独特之处在于优先面向 AMD 的本地加速,尤其适用于 GPU 和 NPU 都属于客户端平台组成部分的系统。
| 工具 | 最适合的场景 | API 风格 | 硬件侧重点 | 常见取舍 |
|---|---|---|---|---|
| Lemonade | AMD 本地 GPU/NPU 推理服务 | 本地 HTTP / 类似 OpenAI 的使用方式 | AMD 客户端硬件 | 生态系统比老牌服务器更年轻 |
| Ollama | 简单的本地模型管理 | REST API | 广泛支持 CPU/GPU | 对底层执行的控制较少 |
| llama.cpp 服务器 | 可移植的量化推理 | REST / OpenAI 兼容模式 | CPU、Metal、CUDA、Vulkan 等 | 后端调优可能需要手动进行 |
| vLLM | 高吞吐量推理服务 | 兼容 OpenAI | 服务器 GPU | 部署所需资源更多 |
| LM Studio | 桌面端本地实验 | 图形界面 + 本地服务器 | 消费级设备 | 不太适合基础设施自动化 |
Lemonade 并不能直接替代所有推理技术栈。如果你使用数据中心 GPU 为数百名并发用户提供服务,vLLM 式的连续批处理通常是更适合的架构。如果你需要在各种机器上实现尽可能广泛的可移植性,llama.cpp 仍然很难被超越。
当目标机器是 AMD 笔记本电脑、工作站或边缘设备,而且你重视的是完善的本地服务器,而非一次性的 Python 脚本时,Lemonade 就值得关注。
实用的本地架构
以下模式很适合本地 AI 应用:
┌──────────────────────────────┐
│ Desktop App / Backend Service │
└───────────────┬──────────────┘
                │ OpenAI-compatible client
                v
┌──────────────────────────────┐
│ Local Model Gateway           │
│ - retries                     │
│ - model routing               │
│ - prompt templates            │
│ - telemetry                   │
└───────────────┬──────────────┘
                │ localhost HTTP
                v
┌──────────────────────────────┐
│ Lemonade Server               │
│ - model loading               │
│ - streaming responses         │
│ - device selection            │
│ - accelerator backend         │
└───────────────┬──────────────┘
                │
       ┌────────┴────────┐
       v                 v
   AMD GPU            Ryzen AI NPU
即使本地服务器已经提供清晰的 API,我通常仍会添加一个轻量网关。网关为你提供稳定的内部接口约定,并让你能够在本地模型与远程模型之间切换。
例如:
import os
from openai import OpenAI

def build_llm_client():
    if os.getenv("LLM_MODE") == "local":
        return OpenAI(
            base_url="http://localhost:8000/api/v1",
            api_key="local"
        )

    return OpenAI(
        base_url=os.environ["REMOTE_LLM_BASE_URL"],
        api_key=os.environ["REMOTE_LLM_API_KEY"]
    )

client = build_llm_client()
这样,你的应用逻辑就无需关心请求是发往 Lemonade、GPT-5.5、Claude Opus 4.8、Gemini 3,还是托管的开放模型。在评估质量、延迟、隐私和成本时,这种灵活性很有价值。如果你的团队使用 AI Prime Tech 等多模型 API 提供商作为云端后备方案,请将本地路径和远程路径封装在同一个接口后面。
模型选择:小模型胜过理论上的高智能
使用本地 LLM 服务器时,最常见的错误是因为模型在排行榜上表现出色就选择它,而不是因为它适合当前机器。
对于本地推理,模型是否适配至关重要:
- 量化后的模型能否装入可用的加速器内存?
- 上下文长度是否符合工作负载的实际需求?
- 首个 token 的等待时间有多长?
- 在笔记本电脑正常的散热条件下,能否流畅地输出流式响应?
- 应用能否容忍偶尔回退到 CPU?
- 质量是否足以完成任务?
量化为 4 位的 7B 或 8B 指令模型,在本地往往比大得多、却不断发生内存溢出、停顿或被迫大幅裁剪上下文的模型更实用。对于编码任务,Qwen、DeepSeek、Llama、MiniMax 和基于 Kimi 的开放模型都可能是合理的候选,具体取决于许可证、格式支持和后端兼容性。
正确的工作流程应以实测为依据:
# Example benchmark flow; adapt names to installed Lemonade commands/models.
lemonade-server pull llama-3.1-8b-instruct-q4
lemonade-server serve --host 127.0.0.1 --port 8000
然后运行一个可重复测试的提示词:
import time
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/api/v1", api_key="local")

prompt = "Explain how an LRU cache works, then implement one in Python."

start = time.perf_counter()
first_token_at = None
tokens = 0

stream = client.chat.completions.create(
    model="llama-3.1-8b-instruct-q4",
    messages=[{"role": "user", "content": prompt}],
    stream=True,
    temperature=0.1,
    max_tokens=400,
)

for chunk in stream:
    text = chunk.choices[0].delta.content or ""
    if text and first_token_at is None:
        first_token_at = time.perf_counter()
    tokens += len(text.split())

end = time.perf_counter()

print({
    "time_to_first_token_s": round(first_token_at - start, 3),
    "total_time_s": round(end - start, 3),
    "rough_word_rate_per_s": round(tokens / (end - start), 2)
})
这并不是科学上完美的基准测试,而是一项实用的冒烟测试。它能让你了解用户的实际感受。
设备选择与回退方案
好的本地服务器应足够明确地呈现设备选择,让工程师能够分析故障原因。“自动”很方便,直到模型悄然从 GPU 转到 CPU,导致延迟增加 8x。
在接近生产环境的本地部署中,我更喜欢朴素且便于检查的配置:
{
  "server": {
    "host": "127.0.0.1",
    "port": 8000
  },
  "models": [
    {
      "name": "local-chat",
      "path": "./models/llama-3.1-8b-instruct-q4",
      "device": "gpu",
      "context_length": 8192
    },
    {
      "name": "fast-draft",
      "path": "./models/small-instruct-npu",
      "device": "npu",
      "context_length": 4096
    }
  ],
  "fallback": {
    "allow_cpu": false,
    "on_failure": "return_error"
  }
}
Lemonade 的具体配置项可能因版本而异,但原则不变:避免不可见的性能下降。如果 GPU 路径失败,我希望应用能够知情。对于交互式应用,返回明确的错误通常比让用户等待 90 秒才收到 CPU 响应更好。
一个常见的陷阱:驱动程序和运行时库与模型同样重要。当 GPU 或 NPU 加速未生效时,服务器可能仍然“能用”,只是速度很慢。务必在启动时通过日志确认当前启用的执行提供程序。
实用的启动检查:
lemonade-server serve --log-level debug查找以下信息:
loaded model: local-chat
selected device: gpu
execution provider: <accelerated backend>
context length: 8192
quantization: q4
如果日志没有清楚显示加速器路径,就应认为你尚未验证加速是否生效。
流式输出是必需的
对于本地 LLM 的用户体验,流式输出是一项必需功能。即使总体完成时间不变,流式输出也会让应用显得快得多,因为用户能够看到进展。
你的服务器应支持 token 流式输出,客户端也应正确处理它:
def stream_answer(client, model, messages):
    stream = client.chat.completions.create(
        model=model,
        messages=messages,
        stream=True,
        temperature=0.2,
        max_tokens=700,
    )

    for event in stream:
        piece = event.choices[0].delta.content
        if piece:
            yield piece
在实践中,流式输出还有助于调试。如果首个 token 的延迟很高,但之后生成很快,瓶颈可能在模型加载、提示词处理或上下文长度上。如果首个 token 很快到达,但后续生成缓慢,则可能遇到了内存带宽限制、热降频或 CPU 回退。
分别测量以下指标:
- 冷启动时间:从服务器启动到模型就绪。
- 提示词处理时间:从收到请求到输出首个 token。
- 解码速度:从首个 token 到最后一个 token。
- 端到端延迟:从应用发出请求到收到完整响应。
- 散热稳定性:使用五分钟后运行同样的测试。
最后一项很容易被忽视,却会在实际产品中带来严重问题。
上下文长度:悄然放大延迟的因素
长上下文窗口很有用,但并非没有代价。即使模型支持 8192 个 token 或 32768 个 token 的上下文,如果你在每次请求中塞满日志、文档和聊天历史,体验仍可能变得糟糕。
对于本地系统,我通常会在网关层强制限制上下文预算:
MAX_PROMPT_CHARS = 18_000

def trim_context(system_prompt, history, new_user_message):
    packed = [
        {"role": "system", "content": system_prompt},
        *history[-8:],
        {"role": "user", "content": new_user_message},
    ]

    total = sum(len(m["content"]) for m in packed)
    while total > MAX_PROMPT_CHARS and len(packed) > 2:
        removed = packed.pop(1)
        total -= len(removed["content"])

    return packed
这种方法粗略,但有效。更成熟的版本会使用 token 计数、语义压缩和检索。关键在于,上下文管理应由应用层负责,而不是模糊地寄希望于服务器始终保持快速响应。
如果你在云端使用 Fable 5 这样具有 1M 上下文的大上下文模型,设计的可行范围就会改变。在本地 GPU/NPU 系统上,除非实测证明并非如此,否则应假定上下文的成本很高。
Lemonade 式本地推理服务的最佳实践
保持服务器预热状态
模型冷加载是最损害用户体验的因素之一。随应用启动服务器,主动预加载默认模型,并将就绪状态与进程健康状态分开提供。
curl http://127.0.0.1:8000/health
curl http://127.0.0.1:8000/models
你的应用应区分以下状态:
- 服务器进程正在运行
- 模型已加载
- 加速器已启用
- 请求路径正常
固定模型版本
不要让桌面应用使用的“最新”模型悄然发生变化。固定模型名称、量化方式和预期上下文长度。
{
  "model": "llama-3.1-8b-instruct-q4",
  "revision": "2025-02-local-tested",
  "expected_device": "gpu"
}
即使分词器、聊天模板或量化方式只有细微变化,也可能改变模型行为。
将质量测试与速度测试分开
对于许多工作流程,快速却给出隐蔽错误答案的本地模型,比速度较慢的模型更糟。我喜欢维护两套测试集:
evals/
  latency_prompts.jsonl
  task_quality_prompts.jsonl
质量测试项示例:
{
  "id": "python_exception_summary_01",
  "messages": [
    {
      "role": "user",
      "content": "Summarize this stack trace and identify the likely bug: ..."
    }
  ],
  "must_include": ["None", "attribute", "guard"],
  "must_not_include": ["database outage"]
}
这不能替代正式评估,但能在更换模型、量化方式或设备路径时发现回归问题。
设计远程回退方案
本地推理会因一些平常的原因失败:笔记本电脑的省电模式、驱动程序更新、模型文件缺失、不支持的量化方式、热降频。如果任务很重要,就应设计回退方案。
try:
    answer = call_local_model(messages, timeout_s=20)
except Exception:
    answer = call_remote_model(messages, timeout_s=30)
明确隐私要求。有些提示词绝不应离开本机。对于这些提示词,应在失败时阻止向外发送。
局限与取舍
在兼容的 AMD 系统上搭配合适的运行时技术栈,Lemonade 最能兑现其承诺。这也意味着,运维需要考虑硬件能力、驱动程序状态、模型格式支持以及加速器后端的成熟度。
主要取舍:
- 可移植性:面向 AMD 的加速很有价值,但异构设备群可能需要多个后端。
- 模型可用性:并非每个开放模型都会针对每种执行路径完成打包或优化。
- NPU 的限制:NPU 非常适合高效推理,但并非所有模型结构或上下文长度都能自然适配。
- 可观测性:本地服务器和云服务一样,也需要日志和指标。
- 并发:一台开发者笔记本电脑并不是多租户推理集群。
务实地看,Lemonade 并不能凭空创造算力。它是在资源有限的客户端硬件上提供更好的本地服务层。性能提升来自选择合适的模型、量化方式和加速器,以及通过服务器 API 将这些细节封装起来,让应用无需处理。
实践要点
- 当你需要由 AMD 加速的本地 LLM 服务器,而不是将推理直接嵌入应用时,可以使用 Lemonade。
- 将 GPU、NPU 和 CPU 视为不同的执行目标,它们在延迟、功耗和模型适配性方面各有特点。
- 优先选择能够提供稳定交互延迟的较小量化模型,而不是勉强能装下的较大模型。
- 通过日志验证加速是否生效;一个“正常运行”的服务器仍可能在使用 CPU。
- 以流式方式返回响应,测量首个 token 的生成时间,并在持续热负载下进行测试。
- 将路由、回退、提示词裁剪和隐私策略放在应用网关中。
- 在发布本地 AI 功能之前,固定模型版本,并维护小规模的延迟和质量评测集。
一个 API 密钥即可使用 Claude Opus 5.5、Sonnet 5、Haiku 4.5 和 Fable 5.1,以及 GPT-6 个模型。按量付费,无需订阅。
获取 API 密钥 →