AMD의 Lemonade: GPU를 사용하는 빠른 오픈 소스 로컬 LLM 서버 ...
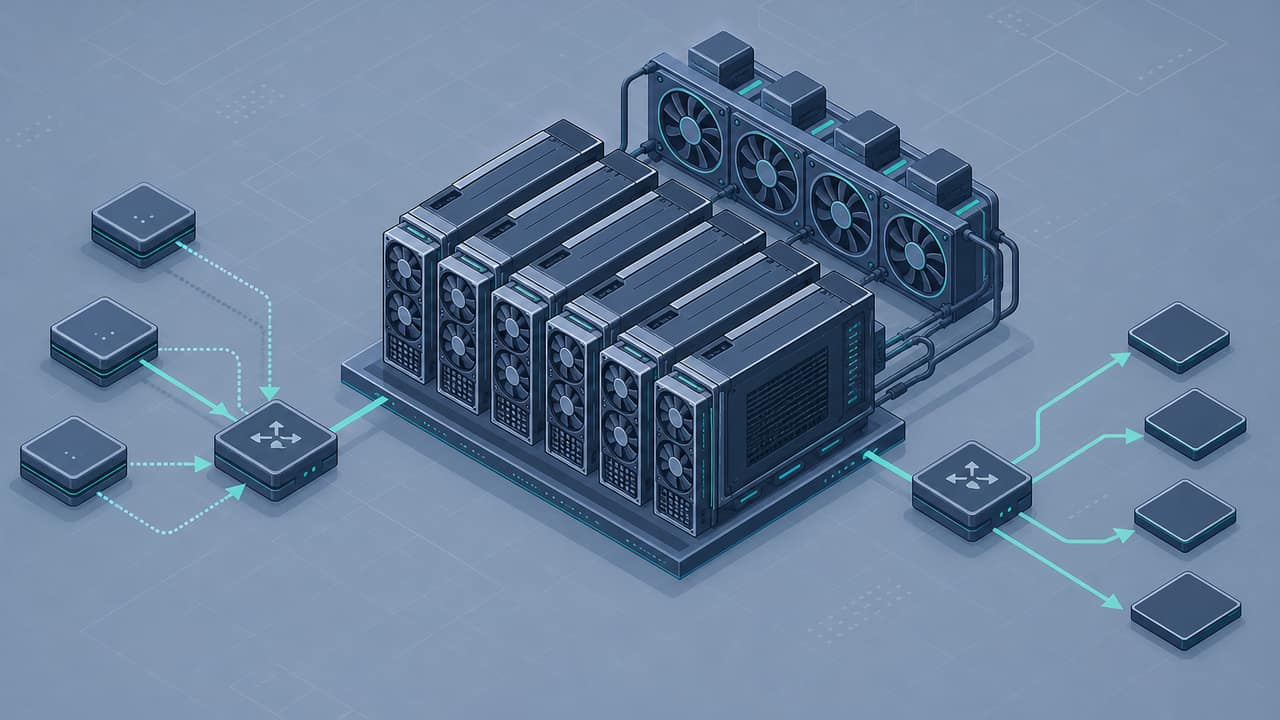
AMD의 Lemonade: GPU와 NPU를 사용하는 빠른 오픈 소스 로컬 LLM 서버
실용적인 로컬 LLM 서버도 20토큰 프롬프트에 답하는 데 18초가 걸리는 순간 더 이상 “로컬”답지 않게 됩니다. 개발자 노트북에서 이런 패턴을 반복해서 보았습니다. 모델은 기술적으로 실행되지만, CPU 사용률은 700%에 고정되고, 팬이 빠르게 돌며, 사용자가 이미 맥락을 놓친 뒤에야 첫 토큰이 도착합니다.
Lemonade가 해결하려는 엔지니어링 문제는 바로 이것입니다. 로컬 추론이 데모 스크립트가 아니라 실제 서비스처럼 느껴지도록 만드는 것입니다.
AMD의 Lemonade는 클라이언트 하드웨어, 특히 GPU와 Ryzen AI NPU 가속을 갖춘 AMD 시스템에서 언어 모델을 실행하도록 설계된 오픈 소스 로컬 LLM 서버입니다. 흥미로운 점은 단순히 “모델을 로컬에서 실행한다”는 데 있지 않습니다. 그렇게 할 수 있는 방법은 이미 여러 가지입니다. 흥미로운 점은 서버 구조에 있습니다. 로컬 모델을 API로 제공하고, 사용 가능한 가속기로 추론을 라우팅하며, 일반적인 애플리케이션 코드에서 사용할 수 있게 합니다.
로컬 코파일럿, 프라이빗 문서 어시스턴트, 에이전트 샌드박스 또는 오프라인 추론 워크플로를 구축하는 엔지니어에게는 이것이 적절한 추상화입니다. 모든 애플리케이션이 모델 로드, 가중치 양자화, 실행 제공자 선택, 메모리 고정, 토큰 스트리밍, 세션 관리 방법을 알아야 하는 구조는 원하지 않을 것입니다. 필요한 것은 로컬 추론 서비스입니다.
Lemonade의 실제 용도
큰 틀에서 보면 Lemonade는 로컬 모델 서버입니다. 애플리케이션과 하드웨어 사이에 위치합니다.
추론 로직을 앱에 직접 내장하는 대신 로컬 데몬을 실행합니다:
lemonade-server serve그런 다음 애플리케이션은 HTTP를 통해 데몬과 통신하며, 흔히 OpenAI 스타일의 채팅 완성 API를 사용합니다:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/api/v1",
    api_key="not-needed-for-local"
)

response = client.chat.completions.create(
    model="llama-3.1-8b-instruct",
    messages=[
        {"role": "system", "content": "You are a concise coding assistant."},
        {"role": "user", "content": "Write a Python function to chunk text by tokens."}
    ],
    temperature=0.2,
    stream=True,
)

for chunk in response:
    delta = chunk.choices[0].delta.content
    if delta:
        print(delta, end="", flush=True)
API 구조는 중요합니다. 백엔드가 이미 GPT-5.5, Claude Sonnet 4.6, Gemini 3 또는 개방형 모델 엔드포인트를 지원한다면, 동일한 클라이언트 추상화가 Lemonade를 가리키도록 설정하여 로컬 실행에 사용할 수 있는 경우가 많습니다. 이를 통해 새로운 SDK에 맞춰 앱을 다시 작성하지 않고도 모델 라우팅, 개인정보 보호가 중요한 기능, 오프라인 워크플로를 테스트할 수 있습니다.
실제로 저는 로컬 LLM 서버를 인프라 구성 요소로 취급합니다:
App / IDE / Agent Runtime
        |
        | HTTP streaming chat API
        v
Lemonade local server
        |
        | model loader + scheduler
        v
Execution backend
        |
        | GPU / NPU / CPU fallback
        v
AMD client hardware
이처럼 명확하게 분리되어 있기 때문에 실제 시스템에서 사용할 수 있습니다.
GPU와 NPU가 모두 중요한 이유
대부분의 엔지니어는 LLM 추론에서 GPU 가속이 중요한 이유를 이미 이해하고 있습니다. 행렬 곱셈이 실행 시간의 대부분을 차지하고, GPU는 병렬 연산을 위해 만들어졌기 때문입니다. NPU는 비교적 새로운 요소이며 오해하기도 더 쉽습니다.
NPU는 “더 작은 GPU”가 아닙니다. 엄격한 전력 및 발열 제약 아래에서 신경망 연산을 수행하도록 최적화된 특수 가속기입니다. 노트북에서는 이 점이 중요합니다. 최상의 로컬 추론 스택이 언제나 30초 벤치마크에서 초당 토큰 수가 가장 높게 나오는 스택인 것은 아닙니다. 사용자가 Slack, 브라우저, VS Code, Docker를 실행하는 동안에도 응답성을 유지하는 스택인 경우가 많습니다.
이해에 도움이 되는 관점:
- GPU: 더 큰 모델, 더 높은 처리량, 더 많은 병렬 연산에 적합합니다.
- NPU: 저전력으로 상시 실행되는 소형 모델이나 최적화된 모델에 매력적인 선택입니다.
- CPU: 안정적인 대체 수단이지만, 대화형 LLM 사용에서는 대체로 지연 시간이 깁니다.
- 하이브리드 시스템: 모델 크기, 양자화, 사용 가능 여부에 따라 작업을 라우팅할 때 유용합니다.
예를 들어 로컬 어시스턴트는 다음을 사용할 수 있습니다:
{
  "routes": {
    "autocomplete": {
      "model": "small-code-model",
      "device": "npu",
      "max_tokens": 64
    },
    "chat": {
      "model": "llama-3.1-8b-instruct-q4",
      "device": "gpu",
      "max_tokens": 1024
    },
    "summarization": {
      "model": "compact-instruct",
      "device": "auto",
      "max_tokens": 512
    }
  }
}
제가 선호하는 방식은 이것입니다. 하나의 가속기를 맹목적으로 고집하지 마세요. 워크로드마다 적합한 실행 대상을 선택하세요.
로컬 LLM 서버 중 Lemonade의 위치
이제는 성숙한 로컬 추론 솔루션이 여러 가지 있습니다. Lemonade의 차별점은 AMD 중심의 로컬 가속에 있으며, 특히 GPU와 NPU가 모두 클라이언트 플랫폼에 포함된 시스템에 중점을 둡니다.
| 도구 | 가장 적합한 용도 | API 스타일 | 주요 하드웨어 | 일반적인 절충점 |
|---|---|---|---|---|
| Lemonade | AMD 로컬 GPU/NPU 서빙 | 로컬 HTTP / OpenAI와 유사한 사용 방식 | AMD 클라이언트 하드웨어 | 기존 서버보다 역사가 짧은 생태계 |
| Ollama | 간편한 로컬 모델 관리 | REST API | 폭넓은 CPU/GPU 지원 | 저수준 실행에 대한 제어가 제한적 |
| llama.cpp 서버 | 이식성이 높은 양자화 추론 | REST / OpenAI 호환 모드 | CPU, Metal, CUDA, Vulkan 등 | 백엔드 튜닝에 수동 작업이 필요할 수 있음 |
| vLLM | 고처리량 서빙 | OpenAI 호환 | 서버용 GPU | 더 많은 배포 리소스 필요 |
| LM Studio | 데스크톱에서의 로컬 실험 | GUI + 로컬 서버 | 일반 소비자용 컴퓨터 | 인프라 자동화에 덜 적합 |
Lemonade가 모든 추론 스택을 그대로 대체할 수 있는 것은 아닙니다. 데이터센터 GPU로 수백 명의 동시 사용자에게 서비스를 제공한다면, 일반적으로 vLLM 방식의 연속 배칭이 더 적합한 아키텍처입니다. 다양한 컴퓨터에서 최대한 폭넓은 이식성이 필요하다면, 여전히 llama.cpp를 능가하기는 어렵습니다.
대상 장치가 AMD 노트북, 워크스테이션 또는 엣지 장치이고, 일회성 Python 스크립트보다 제대로 갖춰진 로컬 서버를 중요하게 생각한다면 Lemonade가 매력적인 선택이 됩니다.
실용적인 로컬 아키텍처
로컬 AI 애플리케이션에 잘 맞는 패턴은 다음과 같습니다.
┌──────────────────────────────┐
│ Desktop App / Backend Service │
└───────────────┬──────────────┘
                │ OpenAI-compatible client
                v
┌──────────────────────────────┐
│ Local Model Gateway           │
│ - retries                     │
│ - model routing               │
│ - prompt templates            │
│ - telemetry                   │
└───────────────┬──────────────┘
                │ localhost HTTP
                v
┌──────────────────────────────┐
│ Lemonade Server               │
│ - model loading               │
│ - streaming responses         │
│ - device selection            │
│ - accelerator backend         │
└───────────────┬──────────────┘
                │
       ┌────────┴────────┐
       v                 v
   AMD GPU            Ryzen AI NPU
저는 로컬 서버가 이미 깔끔한 API를 제공하더라도 보통 가벼운 게이트웨이를 추가합니다. 게이트웨이는 안정적인 내부 인터페이스 규약을 제공하고, 로컬 모델과 원격 모델 사이를 전환할 수 있게 해 줍니다.
예를 들면:
import os
from openai import OpenAI

def build_llm_client():
    if os.getenv("LLM_MODE") == "local":
        return OpenAI(
            base_url="http://localhost:8000/api/v1",
            api_key="local"
        )

    return OpenAI(
        base_url=os.environ["REMOTE_LLM_BASE_URL"],
        api_key=os.environ["REMOTE_LLM_API_KEY"]
    )

client = build_llm_client()
그러면 앱 로직은 요청이 Lemonade, GPT-5.5, Claude Opus 4.8, Gemini 3 또는 호스팅된 개방형 모델 중 어디로 전달되는지 신경 쓸 필요가 없습니다. 이러한 유연성은 품질, 지연 시간, 개인정보 보호, 비용을 평가할 때 유용합니다. 팀에서 클라우드 폴백을 위해 AI Prime Tech와 같은 다중 모델 API 제공업체를 사용한다면, 로컬 경로와 원격 경로를 동일한 인터페이스 뒤에 두세요.
모델 선택: 이론적인 지능보다 작은 크기가 유리합니다
로컬 LLM 서버를 사용할 때 가장 흔한 실수는 장치에 적합한지가 아니라 리더보드에서 좋은 성적을 보인다는 이유로 모델을 선택하는 것입니다.
로컬 추론에서는 모델이 장치에 얼마나 잘 맞는지가 무엇보다 중요합니다.
- 양자화된 모델이 사용 가능한 가속기 메모리에 들어가나요?
- 컨텍스트 길이가 워크로드에 현실적으로 적합한가요?
- 첫 토큰까지 걸리는 시간은 얼마나 되나요?
- 노트북의 일반적인 발열 조건에서도 원활하게 스트리밍되나요?
- 앱이 간헐적인 CPU 폴백을 감당할 수 있나요?
- 작업에 필요한 품질을 충분히 제공하나요?
4비트로 양자화한 7B 또는 8B 인스트럭션 모델은, 메모리를 계속 초과하거나 실행이 지연되거나 컨텍스트를 과도하게 잘라내야 하는 훨씬 큰 모델보다 로컬 환경에서 더 유용한 경우가 많습니다. 코딩 작업에서는 라이선스, 형식 지원, 백엔드 호환성에 따라 Qwen, DeepSeek, Llama, MiniMax, Kimi 계열의 개방형 모델이 모두 합리적인 후보가 될 수 있습니다.
올바른 워크플로는 실측에 기반합니다.
# Example benchmark flow; adapt names to installed Lemonade commands/models.
lemonade-server pull llama-3.1-8b-instruct-q4
lemonade-server serve --host 127.0.0.1 --port 8000
그런 다음 반복 실행할 수 있는 프롬프트를 실행하세요.
import time
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/api/v1", api_key="local")

prompt = "Explain how an LRU cache works, then implement one in Python."

start = time.perf_counter()
first_token_at = None
tokens = 0

stream = client.chat.completions.create(
    model="llama-3.1-8b-instruct-q4",
    messages=[{"role": "user", "content": prompt}],
    stream=True,
    temperature=0.1,
    max_tokens=400,
)

for chunk in stream:
    text = chunk.choices[0].delta.content or ""
    if text and first_token_at is None:
        first_token_at = time.perf_counter()
    tokens += len(text.split())

end = time.perf_counter()

print({
    "time_to_first_token_s": round(first_token_at - start, 3),
    "total_time_s": round(end - start, 3),
    "rough_word_rate_per_s": round(tokens / (end - start), 2)
})
이는 과학적으로 완벽한 벤치마크가 아닙니다. 실용적인 스모크 테스트입니다. 사용자가 어떻게 느낄지 알려 줍니다.
장치 선택과 폴백
좋은 로컬 서버는 엔지니어가 실패 원인을 판단할 수 있을 만큼 장치 선택을 명확하게 드러내야 합니다. “자동”은 편리하지만, 모델이 알림 없이 GPU에서 CPU로 이동해 지연 시간이 8x만큼 급증하면 문제가 됩니다.
프로덕션과 유사한 로컬 배포에서는 단순하고 확인하기 쉬운 설정을 선호합니다.
{
  "server": {
    "host": "127.0.0.1",
    "port": 8000
  },
  "models": [
    {
      "name": "local-chat",
      "path": "./models/llama-3.1-8b-instruct-q4",
      "device": "gpu",
      "context_length": 8192
    },
    {
      "name": "fast-draft",
      "path": "./models/small-instruct-npu",
      "device": "npu",
      "context_length": 4096
    }
  ],
  "fallback": {
    "allow_cpu": false,
    "on_failure": "return_error"
  }
}
Lemonade에서 제공하는 구체적인 설정 항목은 버전에 따라 다를 수 있지만, 원칙은 같습니다. 드러나지 않는 성능 저하를 피해야 합니다. GPU 경로가 실패하면 앱이 이를 알 수 있어야 합니다. 대화형 애플리케이션에서는 사용자가 CPU 응답을 90초 동안 기다리게 하는 것보다 명확한 오류를 반환하는 편이 더 나은 경우가 많습니다.
흔히 놓치는 점이 있습니다. 드라이버와 런타임 라이브러리는 모델만큼 중요합니다. GPU 또는 NPU 가속이 활성화되지 않아도 서버는 여전히 “작동”할 수 있지만, 속도가 느릴 뿐입니다. 시작할 때 로그에서 활성 실행 공급자를 반드시 확인하세요.
유용한 시작 시 점검 항목:
lemonade-server serve --log-level debug확인할 사항:
loaded model: local-chat
selected device: gpu
execution provider: <accelerated backend>
context length: 8192
quantization: q4
로그에 가속기 경로가 명확하게 표시되지 않는다면, 아직 가속을 검증하지 못한 것으로 간주하세요.
스트리밍은 필수입니다
로컬 LLM UX에서 스트리밍은 필수 요건입니다. 전체 완료 시간이 같더라도 사용자가 진행 상황을 볼 수 있으므로, 스트리밍은 앱이 훨씬 빠르게 느껴지도록 합니다.
서버는 토큰 스트리밍을 지원해야 하며, 클라이언트는 이를 올바르게 처리해야 합니다.
def stream_answer(client, model, messages):
    stream = client.chat.completions.create(
        model=model,
        messages=messages,
        stream=True,
        temperature=0.2,
        max_tokens=700,
    )

    for event in stream:
        piece = event.choices[0].delta.content
        if piece:
            yield piece
실제로 스트리밍은 디버깅에도 도움이 됩니다. 첫 토큰 지연 시간이 길지만 이후 생성이 빠르다면, 모델 로딩, 프롬프트 처리 또는 컨텍스트 길이가 병목일 수 있습니다. 첫 토큰은 빠르게 도착하지만 이후 생성이 매우 느리다면, 메모리 대역폭, 열 스로틀링 또는 CPU 폴백이 원인일 수 있습니다.
다음 항목을 각각 측정하세요.
- 콜드 스타트 시간: 서버 시작부터 모델 준비 완료까지.
- 프롬프트 처리 시간: 요청 수신부터 첫 토큰까지.
- 디코딩 속도: 첫 토큰부터 마지막 토큰까지.
- 엔드투엔드 지연 시간: 애플리케이션 요청부터 전체 응답까지.
- 열 안정성: 5분 동안 사용한 뒤 동일한 테스트 수행.
마지막 항목은 간과하기 쉽지만 실제 제품에서는 큰 문제를 일으킵니다.
컨텍스트 길이: 눈에 띄지 않게 지연 시간을 늘리는 요인
긴 컨텍스트 윈도는 유용하지만 비용이 없는 것은 아닙니다. 8192토큰 또는 32768토큰 컨텍스트를 지원하는 모델이라도, 모든 요청을 로그, 문서, 채팅 기록으로 가득 채우면 사용 경험이 나빠질 수 있습니다.
로컬 시스템에서는 보통 게이트웨이에서 컨텍스트 한도를 적용합니다.
MAX_PROMPT_CHARS = 18_000

def trim_context(system_prompt, history, new_user_message):
    packed = [
        {"role": "system", "content": system_prompt},
        *history[-8:],
        {"role": "user", "content": new_user_message},
    ]

    total = sum(len(m["content"]) for m in packed)
    while total > MAX_PROMPT_CHARS and len(packed) > 2:
        removed = packed.pop(1)
        total -= len(removed["content"])

    return packed
단순한 방법이지만 효과적입니다. 더 발전된 방식은 토큰 수 계산, 의미적 압축, 검색을 사용합니다. 중요한 점은 컨텍스트 관리를 애플리케이션 계층에서 처리해야 한다는 것입니다. 서버가 계속 빠르게 동작하리라는 막연한 기대에 맡겨서는 안 됩니다.
클라우드 환경에서 1M 컨텍스트를 갖춘 Fable 5와 같은 대규모 컨텍스트 모델을 사용한다면, 설계상 가능한 범위가 달라집니다. 로컬 GPU/NPU 시스템에서는 측정으로 달리 확인하지 않은 이상 컨텍스트 비용이 높다고 가정해야 합니다.
Lemonade 방식의 로컬 서빙 모범 사례
서버를 준비된 상태로 유지하세요
콜드 상태에서의 모델 로딩은 UX를 해치는 가장 큰 요인 중 하나입니다. 앱과 함께 서버를 시작하고, 기본 모델을 미리 로드하며, 준비 상태를 프로세스 상태와 별도로 제공하세요.
curl http://127.0.0.1:8000/health
curl http://127.0.0.1:8000/models
앱은 다음 상태를 구분해야 합니다.
- 서버 프로세스가 실행 중임
- 모델이 로드됨
- 가속기가 활성화됨
- 요청 경로가 정상임
모델 버전을 고정하세요
데스크톱 앱에서 “최신” 모델이 사용자 모르게 바뀌도록 두지 마세요. 모델 이름, 양자화 방식, 예상 컨텍스트 길이를 고정하세요.
{
  "model": "llama-3.1-8b-instruct-q4",
  "revision": "2025-02-local-tested",
  "expected_device": "gpu"
}
토크나이저, 채팅 템플릿 또는 양자화가 조금만 바뀌어도 동작이 달라질 수 있습니다.
품질 테스트와 속도 테스트를 분리하세요
많은 워크플로에서는 미묘하게 잘못된 답변을 내놓는 빠른 로컬 모델보다 느린 모델이 더 낫습니다. 저는 두 가지 테스트 세트를 유지하는 편입니다.
evals/
  latency_prompts.jsonl
  task_quality_prompts.jsonl
품질 테스트 항목 예시:
{
  "id": "python_exception_summary_01",
  "messages": [
    {
      "role": "user",
      "content": "Summarize this stack trace and identify the likely bug: ..."
    }
  ],
  "must_include": ["None", "attribute", "guard"],
  "must_not_include": ["database outage"]
}
이는 정식 평가를 대체하지는 않지만, 모델, 양자화 또는 장치 경로를 변경할 때 성능이나 동작의 퇴행을 잡아냅니다.
원격 폴백을 고려해 설계하세요
로컬 추론은 노트북 절전 모드, 드라이버 업데이트, 모델 파일 누락, 지원되지 않는 양자화, 열 스로틀링처럼 흔한 이유로 실패합니다. 중요한 작업이라면 폴백을 설계하세요.
try:
    answer = call_local_model(messages, timeout_s=20)
except Exception:
    answer = call_remote_model(messages, timeout_s=30)
개인정보 보호 방침을 명확히 하세요. 일부 프롬프트는 절대로 장치 밖으로 나가서는 안 됩니다. 이러한 프롬프트는 실패 시 외부 전송을 차단하세요.
한계와 절충점
Lemonade의 장점은 적절한 런타임 스택을 갖춘 호환 AMD 시스템에서 가장 잘 드러납니다. 이는 운영 시 하드웨어 성능, 드라이버 상태, 모델 형식 지원, 가속기 백엔드의 성숙도까지 고려해야 한다는 의미이기도 합니다.
주요 절충점:
- 이식성: AMD에 초점을 맞춘 가속은 유용하지만, 여러 종류의 장치로 구성된 환경에서는 여러 백엔드가 필요할 수 있습니다.
- 모델 가용성: 모든 개방형 모델이 모든 실행 경로에 맞게 패키징되거나 최적화되는 것은 아닙니다.
- NPU의 제약: NPU는 효율적인 추론에 탁월하지만, 모든 모델 구조나 컨텍스트 길이에 적합한 것은 아닙니다.
- 관측 가능성: 로컬 서버에도 클라우드 서비스와 마찬가지로 로그와 메트릭이 필요합니다.
- 동시 처리: 개발자 노트북 한 대는 멀티테넌트 추론 클러스터가 아닙니다.
현실적으로 보면 Lemonade가 마법처럼 처리 용량을 늘려 주는 것은 아닙니다. 한정된 클라이언트 하드웨어 위에서 더 나은 로컬 서빙 계층을 제공합니다. 성능 향상은 적절한 모델, 적절한 양자화, 적절한 가속기, 그리고 애플리케이션이 이러한 세부 사항을 신경 쓰지 않도록 해 주는 서버 API를 사용하는 데서 나옵니다.
실무 핵심 요점
- 앱에 추론 기능을 직접 내장하는 대신 AMD 가속을 활용하는 로컬 LLM 서버가 필요하다면 Lemonade를 사용하세요.
- GPU, NPU, CPU는 지연 시간, 전력 소비, 모델 적합성 특성이 서로 다른 실행 대상으로 취급하세요.
- 간신히 메모리에 들어가는 큰 모델보다 대화형 사용에 적합한 지연 시간을 안정적으로 제공하는 작은 양자화 모델을 우선하세요.
- 로그로 가속 여부를 확인하세요. 서버가 ‘작동’하더라도 여전히 CPU에서 실행되고 있을 수 있습니다.
- 응답을 스트리밍하고, 첫 토큰까지의 시간을 측정하며, 열 부하가 지속되는 조건에서 테스트하세요.
- 라우팅, 폴백, 프롬프트 길이 조정, 개인정보 보호 정책은 애플리케이션 게이트웨이에서 처리하세요.
- 로컬 AI 기능을 출시하기 전에 모델 버전을 고정하고 지연 시간과 품질을 평가하는 소규모 평가 세트를 유지하세요.
API 키 하나로 Claude Opus 5.5, Sonnet 5, Haiku 4.5, Fable 5.1 및 GPT-6개 모델을 이용하세요. 구독 없이 사용한 만큼만 결제합니다.
API 키 받기 →